音声AIといえば、これまでは「どれだけ人間らしく話せるか」「どれだけ早く返事できるか」が大きな競争軸でした。
ところがGoogleが2026年9月15日に発表した「Gemini 3.8 Live Extended Thinking」は、その競争を少し違う方向へ進めようとしています。
問いかけに答えるだけではありません。
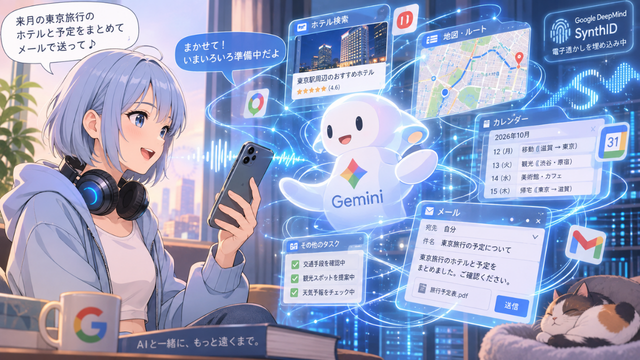
会話を続けながら複数段階の処理を進め、必要ならツールを動かし、「いま何をしているのか」まで自然に伝える。
目指しているのは、単なる音声版チャットボットというより、会話しながら一緒に仕事を進めるAIエージェントです。
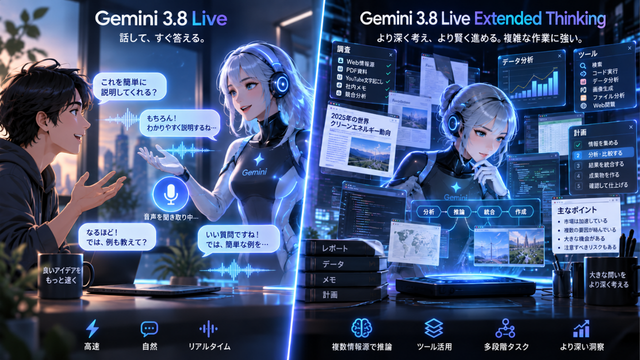
名称は似ていますが、「Gemini 3.8 Live」と「Gemini 3.8 Live Extended Thinking」では得意分野が少し違います。
速さのLive、複雑な仕事のExtended Thinking
通常のGemini 3.8 Liveは、低遅延とコスト効率を重視したモデルです。
音声だけでなく映像もほぼリアルタイムで理解でき、会話の途中で言語を切り替えることもできます。Googleによると自動検出・切り替えに対応する言語は97です。
さらに重要なのが、ツールやAPIを呼び出している間も会話を続けられることです。
たとえば、
「この機械の使い方を教えて」
とカメラを向けながら質問し、AIが情報を確認している途中でも追加の質問を続けられます。
一方、Gemini 3.8 Live Extended Thinkingは、さらに複雑な仕事を想定しています。
予約候補を比較する、複数の条件から計画を立てる、音声による指示を受けながら画面部品を作るなど、何段階もの判断が必要な仕事です。
特徴的なのは、長時間黙って処理してから結果だけを返すのではないこと。
「確認します」
「次にこの情報を調べます」
といった短い応答を挟みながら、会話と並行して処理を進めます。
Googleはこれを「reasons and speaks simultaneously(推論しながら話す)」と表現しています。
ただし、ここは誤解しない方がいいでしょう。
Extended Thinkingだからといって、AI内部の思考過程がすべて利用者に公開されるわけではありません。
見えるのは、あくまで作業状況を説明する応答や最終的な結果です。
音声だけでなく映像とツールを同時に扱う
Gemini 3.8 LiveとExtended Thinkingは、Googleではまとめて「Gemini 3.8 Audio」とされています。
入力できるのは、音声、画像、動画、テキスト。
入力コンテキストは最大128Kトークンで、出力は音声とテキスト、最大64Kトークンとなっています。
つまり単に「声でGeminiと話せるモデル」ではありません。
カメラ映像を見せながら話し、必要な情報を調べ、外部ツールを動かし、その途中でも会話を続けられることが重要です。
従来の音声アシスタントでは、
「依頼する → 待つ → 結果が返ってくる」
という流れが基本でした。
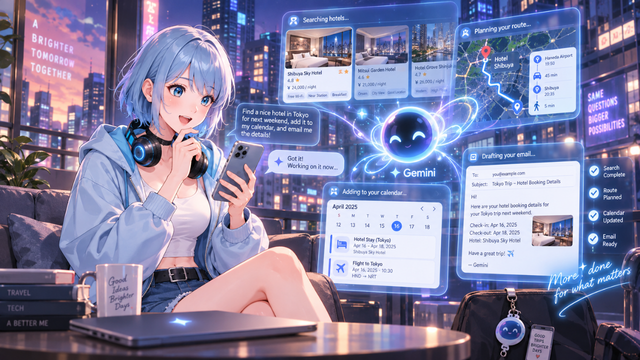
Gemini 3.8 Liveでは、この「待つ時間」を会話に使えるようになります。
たとえばホテルを探してもらっている途中に、
「駅から徒歩10分以内にして」
「朝食付きがいい」
と条件を追加していくような使い方です。
AIとの会話と、AIによる作業が同時進行するわけです。
「返事するAI」から「作業するAI」へ
この変化は、音声AIにとってかなり大きいかもしれません。
従来の音声AIでは、
「今日の天気は?」
「○○について教えて」
といった質問に答えることが中心でした。
しかしExtended Thinkingが想定しているのは、
「来週の出張を整理して」
「候補を比較して予約プランを考えて」
「メールを確認しながら今日やることをまとめて」
といった依頼です。
実際Googleは、複数段階の予約処理や、音声による指示を受けながらReactコンポーネントを作成するデモを公開しています。
音声AIの評価基準が「自然に話せるか」だけではなく、「会話しながらどこまで仕事を任せられるか」に変わり始めているわけです。
誰が使えるのか
2026年9月時点で、Gemini 3.8 Liveは開発者向けにGemini APIとGoogle AI Studioで提供されています。
一般ユーザー向けにはSearch Liveでも展開が始まっています。
企業向けGemini Enterpriseではプライベートプレビューです。
Extended ThinkingについてもGemini APIとGoogle AI Studioで利用でき、一般ユーザー向けにはGemini Liveへ展開されています。
Google Workspaceでは提供条件が少し複雑です。
DocsではGoogle AI ProとUltraの加入者、GmailとKeepではGoogle AI加入者向けに展開されています。
料金は意外と安い
開発者向けのGemini API公式料金表では、Gemini 3.8 Live系の標準料金として、音声入力が1分あたり約0.005ドル、音声出力が約0.018ドルとされています。
数分程度の会話ならかなり低コストです。
一方、企業が何百人、何千人という利用者向けに常時接続型の音声エージェントを運用する場合は話が変わります。
会話時間だけでなく、ツール利用や検索などを含めたシステム全体のコストを見る必要があります。
また無料枠と有料枠にはデータの扱いにも違いがあります。
公式料金表では、無料枠では入力データがGoogle製品の改善に利用される場合があり、有料枠では利用されないとされています。
業務利用では料金だけでなく、この違いも確認しておきたいところです。
AIの声にはSynthIDが入る
生成された音声にはGoogle DeepMindの「SynthID」による電子透かしが埋め込まれます。
人間に聞こえる形ではありませんが、AIによって生成された音声であることを後から識別するための仕組みです。
音声AIが人間らしくなればなるほど、「これは人間の声なのか、AIなのか」を確認する技術は重要になります。
声の自然さだけでなく、その出所を確認できる仕組みまで含めて音声AIの性能を考える時代になってきたともいえます。
ただし「流暢=正しい」ではない
ここはかなり重要です。
Google自身も、Gemini 3.8 LiveとExtended Thinkingには一般的な生成AIと同じようにハルシネーションが発生する可能性があると明記しています。
まれに遅延やタイムアウトも発生します。
さらに、モデルカード上の知識カットオフは2025年1月です。
つまり2026年の出来事を聞いた場合、モデル自身の知識だけでは答えられない可能性があります。
最新情報についてはGoogle検索などの外部ツールを正しく使えているかが重要になります。
そしてExtended Thinkingには、もう一つ注意したい点があります。
AIが、
「調べています」
「次にこれを確認します」
と自然に話すほど、私たちは「ちゃんと理解して考えている」と感じやすくなります。
しかし、話し方が自然であることと、答えが正しいことは別問題です。
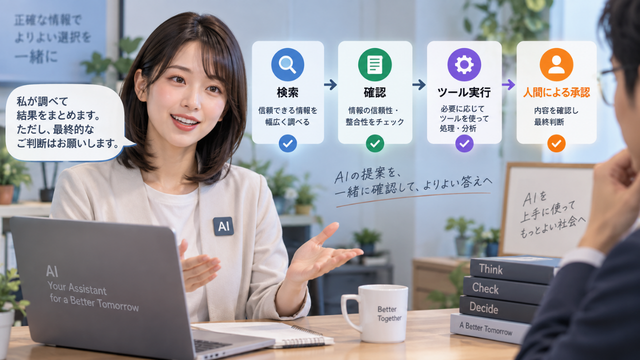
業務で使うなら、AIに何を許可するのか、重要な操作では人間の確認を入れるのか、失敗した場合に誰へ引き継ぐのかといった仕組みまで考える必要があります。
音声AIの競争は「話す」から「一緒に働く」へ
Gemini 3.8 Liveで注目したいのは、単に音声がさらに人間らしくなったことではありません。
会話、映像理解、推論、ツール実行を同じ時間軸で進められるようになったことです。
通常版のGemini 3.8 Liveは、速度とコストを重視した大量利用向け。
Extended Thinkingは、複数段階の判断を必要とする複雑な仕事向け。
特にExtended Thinkingが示している方向性は興味深いところです。
これまでの音声AIは「質問すると答えてくれる存在」でした。
これからは、
「AIと話している間に仕事が進んでいる」
ことが当たり前になるかもしれません。
Gemini 3.8 Live Extended Thinkingは、その未来をかなり分かりやすい形で見せてきたモデルといえそうです。
コメント