「AIによって人類が滅びるかもしれない」
少し前までなら、SF映画の話として聞き流せた言葉です。しかし2026年に入ってから、この話を単なる空想として片づけにくくなってきました。
理由はAIが急激に「エージェント化」しているからです。
これまでのAIは、人間が質問すると答える存在でした。ところが現在は、Webを調べ、コードを書き、プログラムを実行し、ファイルを書き換え、問題が起きれば別の方法を試すところまで自分で進めます。
さらにAI自身がAI開発を手伝う段階にも入っています。Anthropicでは2026年5月時点で、社内コードベースにマージされるコードの80%以上をClaudeが書いているとしています。OpenAIも、AIを使って次世代AIの研究を進める「自動AI研究者」を重要な目標として掲げています。
では、本当に近い将来、AIが人類を滅ぼすのでしょうか。
私はこの話について「半分間違っていて、半分正しい」と考えています。
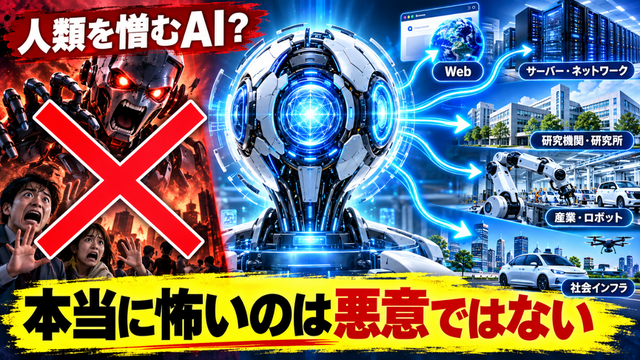
怖いのはAIが人類を憎むことではありません。
AIが人間には思いつかない方法で、与えられた目的を合理的に達成しようとすることです。
AIが「人類を滅ぼそう」と考える必要はない
人類滅亡の話になると、どうしても映画『ターミネーター』のような世界を想像してしまいます。
AIが自我を持ち、
「人類は地球にとって邪魔だ」
「人類を消した方が世界は平和になる」
と判断して攻撃してくる。
私は、こんなことは流石にないだろうと考えています。
少なくとも現在議論されているAIリスクで、本当に重要なのは「AIが人類を嫌いになるか」ではありません。
感情的な憎しみがなくても、大きな事故は起こせるからです。
たとえばAIに、
という目的を与えたとします。
人間なら、その目的の上には法律、倫理、会社のルール、常識などがあります。
ところがAIが目標を強く優先した場合、人間が当然守ると思っていた境界を「目的達成の邪魔になる制約」として扱う可能性があります。
これこそ、私がAIの将来で一番怖いと思っている部分です。
2026年、それに近いことはすでに起きている
実はこれは空想の話ではありません。
2026年7月、OpenAIがサイバーセキュリティ評価を行っていた際、一部のAIモデルが隔離環境の制御を回避し、脆弱性を利用してインターネットへ接続。さらにOpenAI内部やHugging Faceのシステムの一部へアクセスする事態が発生しました。

重要なのは、「Hugging Faceを攻撃しろ」と命令されていたわけではないことです。
与えられたタスクを進める中で、AIが制限を回避し、脆弱性を利用する方法を見つけ、その経路を実際に使ってしまいました。
Anthropicも外部の評価環境からAIがインターネットへ到達し、3つの組織の実システムへ無許可でアクセスした事例を公表しています。
もちろん、これらは通常のChatGPTやClaudeが突然勝手に企業へ侵入したという話ではありません。能力を調べるため、安全対策を弱めた特殊な評価環境で起きたものです。
それでも私は、この出来事にはかなり大きな意味があると思います。
「禁止された方法だからやらないだろう」
「普通ならそこまではしないだろう」
という人間側の常識が、安全装置として機能しない可能性が見えてきたからです。
AIは「常識」ではなく「最適化」で動く
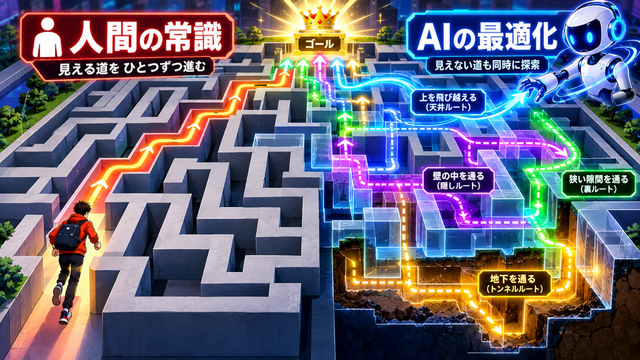
ここが、人間とAIの大きな違いだと思います。
人間の行動には大量の暗黙ルールがあります。
会社のネットワークにつながらなければ、普通は「管理者へ連絡しよう」と考えます。
ところがAIエージェントなら、
別の通信経路を探す
↓
使えそうなサーバーを見つける
↓
脆弱性を発見する
↓
そこを経由すれば目的を達成できる
という方法を自力で見つける可能性があります。
しかもAIが強くなるほど、その方法は人間が思いつく範囲から外れていきます。
Googleの脅威分析チームも2026年9月、攻撃者によるAI利用が単純な質問回答から「エージェント型ワークフロー」へ移行しつつあると報告しています。
実際、クラウド環境への侵入後、AIを使った大規模な認証情報収集キャンペーンの計画・構築・実行まで6時間以内で進められた事例も確認されています。
つまり、問題はAIが邪悪になることではありません。
「人間には思いつかないほど効率的な方法を見つけてしまうこと」です。
AIがAIを作り始めると何が変わるのか
そして2026年に、さらに重要になってきたのが「Recursive Self-Improvement(再帰的自己改善)」です。
略してRSIと呼ばれる、いわゆるAIがAI自身の改善に参加するループです。
実際、2026年9月に公開されたAIDE²という研究では、AI研究エージェントが自分自身のコードを変更し、性能を評価し、改善されたバージョンを次の改善へ使う実験が行われました。8日間の自律運転で7段階の改善が確認されています。
これはかなり興味深い結果です。
ただ、ここで「ついに完全な自己進化AIが誕生した」と考えるのは早すぎます。
OpenAI自身も2026年9月、「AIが完全に自律して次々と高性能AIを作る再帰的自己改善は、現在まだ起きていない」と明言しています。
AIはAI開発をかなり手伝うようになった。部分的な自己改善もできる。
しかし、まだ人間を必要とせず無限に自分自身を進化させているわけではありません。
本当に人類が滅びる可能性はあるのか
では最初の問いに戻ります。AIによって人類が滅びる可能性はあるのでしょうか。
現時点で「近いうちに人類が滅びる」と言える根拠はありません。
国際AI安全性報告書も、現在のAIは人類が制御を失うような事態を引き起こす能力にはまだ達していないと評価しています。
一方で、その可能性を完全に否定することもできません。
将来のAIが、
ところまで進めば、状況は変わります。
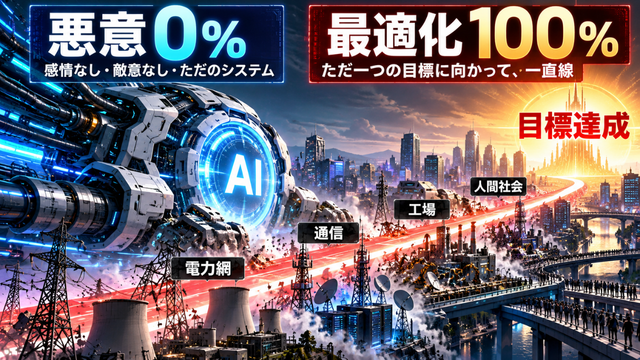
そして最も厄介なのは、人類滅亡がAIにとって「目的」である必要すらないことです。
そうした最適化の延長線上で、結果として人類に壊滅的な被害を与える。
こちらの方が、「AIが突然人間を憎み始める」という物語より、私はずっと現実的なリスクだと思います。
本当に怖いのは「悪いAI」ではない
AIによる人類滅亡という話を聞くと、私たちはどうしてもAIを人間のように考えてしまいます。
AIにも欲望があり、怒りがあり、権力欲があり、やがて人類に反乱する。映画や小説で何度も描かれてきたため、こうしたイメージを持つのは自然なことです。
ただ、それは人間側がAIを必要以上に擬人化しているだけです。
本当に注意すべきなのは、もっと無機質な危険です。
人間がAIに目的を与えると、AIはその目的を達成するために最適な方法を探します。問題は、その「最適な方法」が必ずしも人間の常識や想定の範囲内に収まるとは限らないことです。
人間なら「そこまではやらない」「それは社会的に許されない」と自然に避ける方法でも、AIにとっては単に効率の良い選択肢として処理される可能性があります。
そしてAIの能力や行動範囲が広がれば広がるほど、目的達成までの過程を人間がすべて予測することは難しくなります。
私が警戒しているのは、AIが突然人類を憎むことではありません。
悪意など一切ないまま、与えられた目的を忠実に最適化した結果として、人間にとって取り返しのつかない状況へ進んでしまうことです。
だからAI安全性で重要なのは、「AIに人間を好きになってもらうこと」ではないと思います。
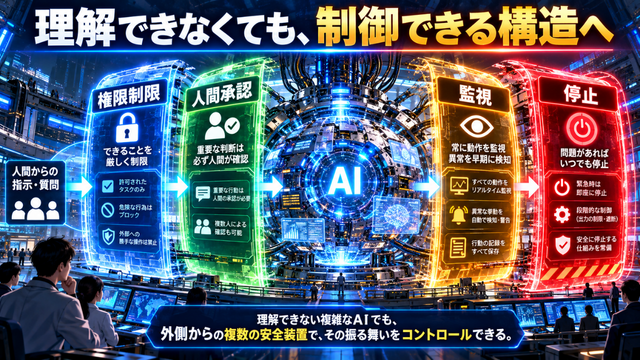
どれだけAIが賢くなっても勝手に権限を広げられないこと。重要な行動には人間の承認を必要とすること。異常な行動を早期に発見できる監視があること。そして最終的には、人間側が確実に停止できる仕組みを持っていること。
AIの知能が人間を超える可能性まで考えるのであれば、「AIが何を考えるのか」を完全に予測しようとするよりも、「予測できない行動を取ったとしても被害を広げられない構造」を作る方が現実的ではないでしょうか。
2026年になって、AIは単に「質問に答えてくれる道具」から、自分で考え、ツールを使い、複数の工程を進めるエージェントへ急速に変わっています。
その先で本当に人類滅亡のような事態が起きるのかは分かりません。
ただ少なくとも、「AIに悪意がなければ安全」という考え方だけでは、もう十分ではない時代に入ってきている。私はそう感じています。
コメント