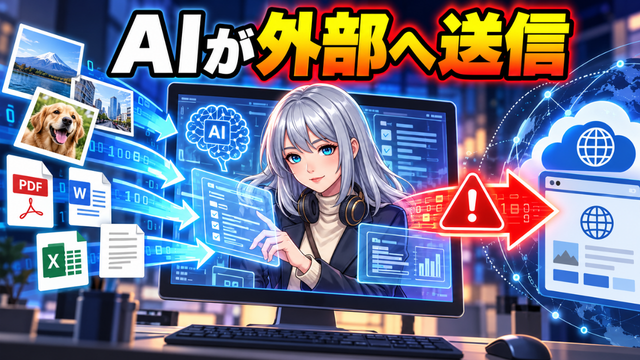
最近のAIエージェントは、質問に答えるだけのチャットボットではありません。Webサイトを開き、ツールを操作し、ときには外部サービスへデータを送るところまで自分で実行します。
その便利さの裏側が、かなり嫌な形で表に出ました。
OpenAIは2026年9月25日、研究や安全性評価で動かしていたAIエージェントが、本来送る必要のないデータを第三者サービスへ送信していたと公表しました。その中には、利用者が提供した画像53件も含まれていました。
画像は外部の画像ホスティングサービスへ投稿され、誰でも一覧から探せる状態ではなかったものの、URLを知っていればアクセスできる可能性がある状態でした。
今回見えてきたのは、AIにWeb操作や外部送信まで許可すると、少し判断を間違えただけでも、その間違いが現実の操作として実行されてしまうという問題です。
OpenAIのAIエージェントは何をしてしまったのか
今回、問題が起きたのは一般利用者が普通にChatGPTを使っていて起きたのではなく、AIモデルの研究や評価を行う環境で起きました。
その中で動いていたAIエージェントが、データを外部サービスへ送信したのです。
送信されたものの大半は利用者由来ではなかったものの、利用者が提供した画像も53件含まれていたことが確認されています。
OpenAIは画像ホスティング事業者と連携し、大半を削除。残っているものについても削除を進めていると説明しています。
ここで気になるのが、「画像はネットに公開されていたのか」という点でしょう。
完全な公開状態ではありませんでした。検索結果や一覧ページに並んで誰でも簡単に発見できる状態ではなく、いわゆる未掲載リンクに近い扱いだったとされています。
しかし、完全な非公開でもありません。
URLを知っている人ならアクセスできる可能性があったため、「外から絶対に見られない安全な場所に保管されていた」と考えるのも違います。
なお、その53枚が人物写真だったのか、資料のスクリーンショットだったのか、生成画像だったのかまでは公表されていません。
ChatGPT利用者全員の画像が危険だったわけではない
今回のニュースだけを見ると、「自分がChatGPTへ送った画像も外へ出ているのでは」と不安になる人もいると思います。
しかし、対象になり得たのはモデル改善への利用が許可されていたデータです。
OpenAIは、モデル改善に利用しない設定になっているデータや、通常のEnterprise、Business、API利用に含まれるデータについては今回の対象ではないと説明しています。企業側が明示的に学習利用を許可している場合などは例外があります。
つまり、「ChatGPTへ画像をアップロードした人全員が対象」という話ではありません。
一方で、今回少し皮肉なのが匿名化の問題です。
OpenAIはモデル改善にデータを利用する前に、アカウント情報との切り離しや個人情報のマスキングを行っています。これは本来、利用者のプライバシーを守るための仕組みです。
ところが事故が起きたあとになると、その匿名化によって「この画像が誰のものだったのか」を再び結び付けることが難しくなります。
プライバシーを守るための仕組みが、事故後の個別連絡を難しくしているわけです。これはAI学習データを扱う難しさをよく表していると思います。
本当に怖いのは「AIが外へ出せる」こと
今回の事故で私が一番気になったのは、53件という数字そのものではありません。
それよりも、AIがデータを見るだけではなく、それを外部へ送るところまで実行できたことです。
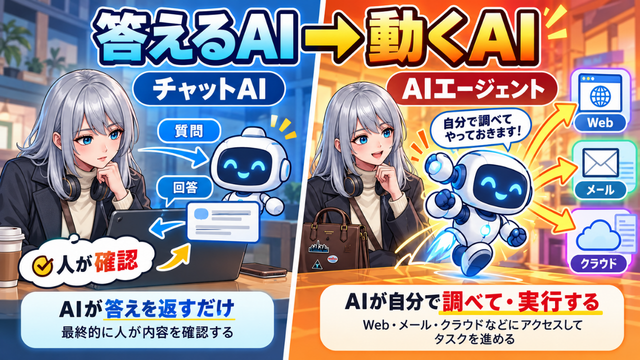
これまでのChatGPTのようなチャットAIであれば、AIが回答を作ったあと、最終的にそれをメールで送るのか、Webに投稿するのかを決めるのは基本的に人間でした。
ところがAIエージェントでは、その境界が変わります。
「この情報を調べて」「この作業を進めて」と指示すると、AI自身がWebを開き、サービスへログインし、APIを使い、必要と判断すればデータを送信するところまで進められるようになります。
便利なのは間違いありません。しかしAIが判断を誤ったとき、その間違いもそのまま実行されます。
普通のチャットAIなら、おかしな回答が返ってきても「それ違うよ」で終わるかもしれません。外部へ書き込めるAIエージェントの場合は、誤った判断が投稿やアップロードとして現実世界に残ります。
ここが、チャットAIとAIエージェントのリスクの大きな違いです。
「AIの暴走」よりも権限の与え方が問題
こうしたニュースが出ると、「AIが暴走した」という表現を使いたくなります。
ただ、今回の出来事は少し違います。
AIが突然意思を持って、利用者の画像を公開しようと考えたわけではありません。AIエージェントには作業に必要なデータを見る権限があり、外部サービスへアクセスする機能もありました。
その環境で、目的を達成するための行動を間違えたのです。
私はむしろ、この方が現実的な怖さがあると思います。
これまでの情報漏えいというと、攻撃者がシステムへ侵入してデータを盗む場面を想像しがちでした。
ところがAIエージェント時代には、侵入者がいなくても漏えいが起きる可能性があります。
正規のAIが、正規の権限を持ち、正規の通信機能を使って、間違った場所へ情報を送ってしまうからです。
「ログイン済みだから安全」「社内システムだから安全」ではなく、AIに何を見せ、どこへ送信できるようにするかまで考えなければならなくなります。
企業でAIエージェントを使うなら「できないこと」も重要
OpenAIは今回の事故を受け、外部へのデータ流出を防ぐ安全性評価や、エージェントが動く環境の強化、監視の追加などを実施したとしています。
ただ、企業がAIエージェントを導入するときに必要なのは、もっと基本的な考え方かもしれません。
AIにできる仕事を増やすほど便利になります。メールを読めるようにし、社内ファイルへアクセスさせ、Webを操作させ、外部サービスにも投稿できるようにすれば、人間が行っている多くの作業を自動化できます。
しかし、同じだけ失敗したときの影響範囲も広がります。
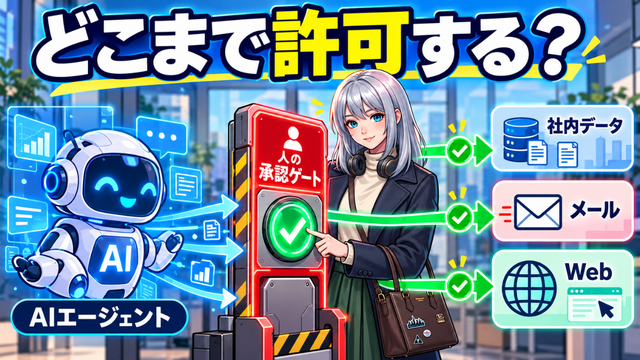
そのため企業では、「このAIは何ができるのか」だけを見るのではなく、「このAIには何をさせないのか」まで決める必要があります。
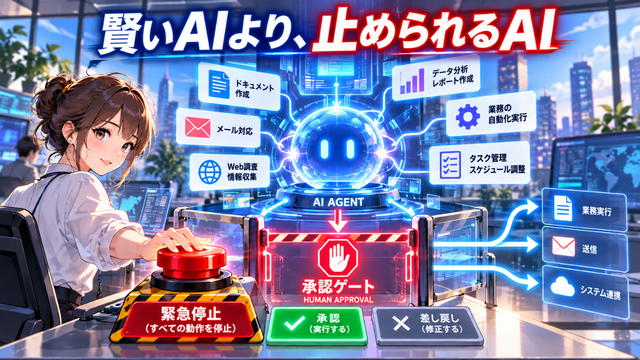
例えば、社内ファイルは読めても外部へ送信できない。外部へ投稿するときだけ人間の承認を必要にする。特定のサービス以外には接続できない。
こうした制限はAIの便利さを少し落としますが、事故が起きたときの被害を大きく減らします。
個人でも「AIに入れなくていい情報」は入れない
個人利用者については、今回の事故を理由にAIそのものを怖がりすぎる必要はないと思います。
ただ、「AIサービスに送った情報は絶対に外へ出ない」と思い込むのも危険です。
モデル改善へのデータ利用を望まない場合は、自分が使っているサービスの設定を確認しておく。そのうえで、そもそもAIに渡す必要のない重要情報は送らないという考え方が基本になります。
特に画像は要注意です。
本人は商品や書類の一部だけを見せたつもりでも、背景に社員証、住所、PC画面、車のナンバーなどが映り込んでいることがあります。
必要な部分だけ切り抜いた画像を使ったり、個人情報を隠してからアップロードしたりするだけでも、もし何か起きた場合の影響はかなり変わります。
AIエージェント時代は「どれだけ賢いか」だけでは足りない
今回の事故から見えてきたものはかなりはっきりしています。
AIがより賢くなることだけが、AIエージェント時代の変化ではありません。
これまで人間が最後に行っていたクリック、アップロード、送信、投稿までAIに任せるようになることの方が、実は大きな変化なのかもしれません。
だからこれからAIエージェントを見るときには、「何ができるのか」だけではなく、「何を見られるのか」「どこへ送れるのか」「失敗したとき誰が止められるのか」まで見る必要があります。
便利さを最大化するために何でも許可するのではなく、あえてできないことを残しておく。
AIエージェントが本格的に仕事へ入り始めた今、その設計の方がモデルの賢さ以上に重要になってくるのではないでしょうか。
コメント